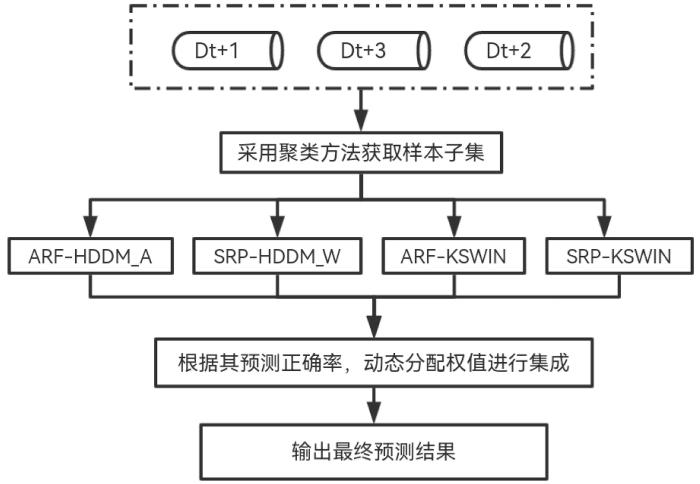
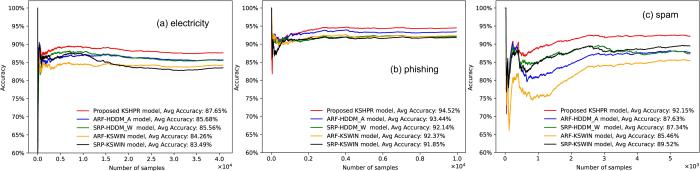
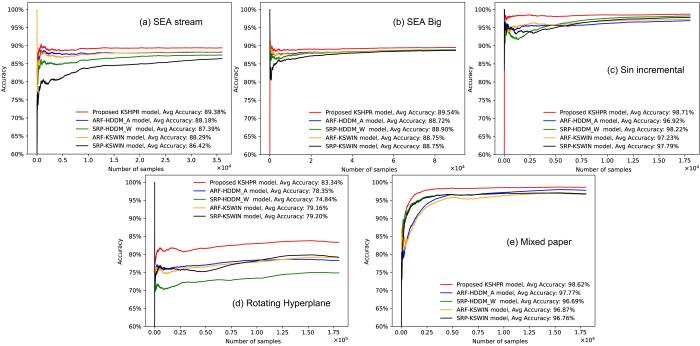
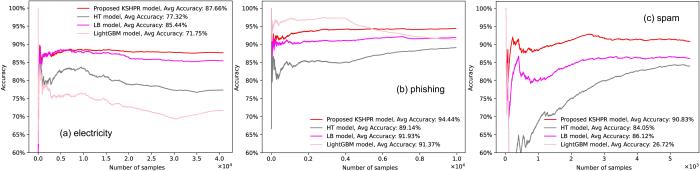
概念漂移是流数据的主要特征之一,如何检测概念漂移的发生以及调整预测模型去适应概念漂移现象备受研究者的关注.目前有关概念漂移的大多数算法仅仅针对单一类型的概念漂移检测,并且需限制输入数据服从某一分布,所以在检测多种类型概念漂移时效果不理想.提出一种在线集成自适应算法(KSHPR),在自适应随机森林(Adaptive Random Forests,ARF)算法和流随机补丁(Streaming Random Patch,SRP)算法的基础上进行优化改进,采用非参数检验与滑动窗口相结合的策略进行概念漂移检测,降低窗口平均值对算法性能的影响,并以此为基础建立四个基学习者的集成学习模型,根据基学习者预测准确率,动态分配权值,有效解决流式数据中学习模型精度低的问题.实验证明,提出的算法在真实数据集和合成数据集中均表现优良,与其他算法相比,该算法的稳定性、分类准确性与多类型概念漂移适应能力均有所提升.
关键词:流数据
;
概念漂移
;
在线学习
;
集成
Abstract
Concept drift is one of the main characteristics of stream data. How to detect the occurrence of concept drift and adjust the prediction model to adapt to the phenomenon of concept drift has attracted attention of researchers. At present,most algorithms about concept drift only aim at single type of concept drift detection,and need to restrict input data to obey a certain distribution,which makes the effect of detecting multiple types of concept drift unsatisfactory. An online ensemble adaptive algorithm (KSHPR) is proposed,which is optimized and improved on the basis of Adaptive Random Forest (ARF) and Streaming Random Patch (SRP) algorithms,adopting the strategy of combining non⁃parametric test and sliding window for concept drift detection,and reducing the influence of the window average on the performance of the algorithm. Based on this,we establish an ensemble learning model of four basic learners,which dynamically allocates weights according to the prediction accuracy of the basic learners,and effectively solves the problem of low accuracy of the learning model in streaming data. Experimental results show that the proposed algorithm performs well in both real datasets and synthetic datasets. Compared with other algorithms,the stability,classification accuracy and multi⁃type concept drift adaptability of the algorithm are improved.
Cui Ruihua, Qi Xiaolong, Liu Yanfang, Lin Ling. Online ensemble adaptive algorithm for concept drift of streaming data. Journal of nanjing University[J], 2023, 59(1): 134-144 doi:10.13232/j.cnki.jnju.2023.01.013
概念漂移是数据分布随时间发生变化的一种现象.不同的文献将概念漂移分为不同的类别,陈志强等[10]将概念漂移分为突变型、渐变型、增量型和重复型四类.De Barros and Santos[11]将概念漂移分为突变型、渐变型和重复型三类,但根据其发生变化的时间来看,主要是数据分布的突然变化和持续一段时间后再变化两种情况.因此,本文将概念漂移分为突变类概念漂移[12]和渐变类概念漂移[13]两大类进行研究.
有关概念漂移的研究主要分两个重点研究方向:一是主动检测数据是否发生概念漂移,二是在检测到概念漂移以后模型如何做自适应的调整.基于此,可将有关概念漂移的算法分为主动方法[14-16]和被动适应[17-18].主动方法通过检测数据分布是否发生变化、分类器的性能是否降低来判断概念漂移,主要针对急促的分布改变,重点在迅速检测到概念漂移的发生以及发生的具体时间点,主要分为基于模型性能、基于窗口机制和假设检验算法.DDM是第一个定义概念漂移检测警告级别和漂移级别的算法,通过检测分类错误率是否降低来判断是否发生概念漂移,在检测突变类概念漂移时效果很好,但对渐变类概念漂移的检测效果不理想.Baena⁃Garc et al[6]在DDM的基础上提出早期漂移检测方法(EDDM),对DDM算法进行改进,使其在渐变类概念漂移中有很好的效果.在此基础上,Frias⁃Blanco et al[7]提出基于Hoeffding不等式识别漂移临界区域的HDDM_A和HDDM_W算法.Bifet and Gavaldà[19]提出自适应滑动窗口算法(Adaptive Sliding Window,ADWIN),采用滑动窗口机制,根据时间和数据分布的改变进行自适应改变,但算法性能取决于窗口的大小,如何选择窗口大小是决定算法性能的关键.
被动适应方法不判断数据分布是否发生变化,而是通过不断地更新分类器来适应概念漂移.被动适应方法主要有基于决策树、增量学习和基于集成的算法.霍夫丁树(Hoeffding Tree,HT)算法[20]是一种基于决策树的算法,使用霍夫丁界来计算选择分割节点所需的样本数量,可以更新其节点以适应新传入的样本,但没有机制来解决特定类型的漂移.Gomes et al[8]提出ARF算法,使用Hoeffding作为基学习者,通过重采样和随机选择节点分裂的特征子集来诱导多样性,但该算法采用局部子空间随机化策略,容易陷入局部最优.在此基础上,Gomes et al[9]提出一种新的自适应集成算法SRP用于流数据分析,使用全局子空间随机化策略以提升算法精确度.ARF和SRP算法均选择ADWIN作为概念漂移检测器,算法性能取决于窗口的大小.
... 近年来有关概念漂移的研究不少,但现有的概念漂移检测适应算法更侧重于单一类型的概念漂移.例如,DDM (Drift Detection Method)[5]通过分类错误率来判断是否发生概念漂移,适用于突变型概念漂移.EDDM (Early Drift Detection Method)[6]改进了DDM,通过分类错误率间的距离来判断是否发生概念漂移,适用于渐变类型概念漂移.HDDM_W和HDDM_A[7]均根据Hoeff⁃ding不等式识别概念漂移,前者适用于渐变型概念漂移,后者对突变型概念漂移效果很好.自适应随机森林(Adaptive Random Forests,ARF)[8]和流随机补丁(Streaming Random Patch,SRP)[9]算法在检测概念漂移后,模型会进行自适应调整,但在面对多种复杂的概念漂移时效果不理想.基于以上,本文改进了ARF和SRP算法,并以此为基础提出一种适应流式数据概念漂移的在线集成自适应算法(KSHPR),实验验证该算法能有效地提高学习模型预测的准确率.与其他算法相比,本文的主要贡献如下: ...
Early drift detection method
2
2006
... 近年来有关概念漂移的研究不少,但现有的概念漂移检测适应算法更侧重于单一类型的概念漂移.例如,DDM (Drift Detection Method)[5]通过分类错误率来判断是否发生概念漂移,适用于突变型概念漂移.EDDM (Early Drift Detection Method)[6]改进了DDM,通过分类错误率间的距离来判断是否发生概念漂移,适用于渐变类型概念漂移.HDDM_W和HDDM_A[7]均根据Hoeff⁃ding不等式识别概念漂移,前者适用于渐变型概念漂移,后者对突变型概念漂移效果很好.自适应随机森林(Adaptive Random Forests,ARF)[8]和流随机补丁(Streaming Random Patch,SRP)[9]算法在检测概念漂移后,模型会进行自适应调整,但在面对多种复杂的概念漂移时效果不理想.基于以上,本文改进了ARF和SRP算法,并以此为基础提出一种适应流式数据概念漂移的在线集成自适应算法(KSHPR),实验验证该算法能有效地提高学习模型预测的准确率.与其他算法相比,本文的主要贡献如下: ...
... 有关概念漂移的研究主要分两个重点研究方向:一是主动检测数据是否发生概念漂移,二是在检测到概念漂移以后模型如何做自适应的调整.基于此,可将有关概念漂移的算法分为主动方法[14-16]和被动适应[17-18].主动方法通过检测数据分布是否发生变化、分类器的性能是否降低来判断概念漂移,主要针对急促的分布改变,重点在迅速检测到概念漂移的发生以及发生的具体时间点,主要分为基于模型性能、基于窗口机制和假设检验算法.DDM是第一个定义概念漂移检测警告级别和漂移级别的算法,通过检测分类错误率是否降低来判断是否发生概念漂移,在检测突变类概念漂移时效果很好,但对渐变类概念漂移的检测效果不理想.Baena⁃Garc et al[6]在DDM的基础上提出早期漂移检测方法(EDDM),对DDM算法进行改进,使其在渐变类概念漂移中有很好的效果.在此基础上,Frias⁃Blanco et al[7]提出基于Hoeffding不等式识别漂移临界区域的HDDM_A和HDDM_W算法.Bifet and Gavaldà[19]提出自适应滑动窗口算法(Adaptive Sliding Window,ADWIN),采用滑动窗口机制,根据时间和数据分布的改变进行自适应改变,但算法性能取决于窗口的大小,如何选择窗口大小是决定算法性能的关键. ...
Online and non?parametric drift detection methods based on Hoeffding's bounds
2
2015
... 近年来有关概念漂移的研究不少,但现有的概念漂移检测适应算法更侧重于单一类型的概念漂移.例如,DDM (Drift Detection Method)[5]通过分类错误率来判断是否发生概念漂移,适用于突变型概念漂移.EDDM (Early Drift Detection Method)[6]改进了DDM,通过分类错误率间的距离来判断是否发生概念漂移,适用于渐变类型概念漂移.HDDM_W和HDDM_A[7]均根据Hoeff⁃ding不等式识别概念漂移,前者适用于渐变型概念漂移,后者对突变型概念漂移效果很好.自适应随机森林(Adaptive Random Forests,ARF)[8]和流随机补丁(Streaming Random Patch,SRP)[9]算法在检测概念漂移后,模型会进行自适应调整,但在面对多种复杂的概念漂移时效果不理想.基于以上,本文改进了ARF和SRP算法,并以此为基础提出一种适应流式数据概念漂移的在线集成自适应算法(KSHPR),实验验证该算法能有效地提高学习模型预测的准确率.与其他算法相比,本文的主要贡献如下: ...
... 有关概念漂移的研究主要分两个重点研究方向:一是主动检测数据是否发生概念漂移,二是在检测到概念漂移以后模型如何做自适应的调整.基于此,可将有关概念漂移的算法分为主动方法[14-16]和被动适应[17-18].主动方法通过检测数据分布是否发生变化、分类器的性能是否降低来判断概念漂移,主要针对急促的分布改变,重点在迅速检测到概念漂移的发生以及发生的具体时间点,主要分为基于模型性能、基于窗口机制和假设检验算法.DDM是第一个定义概念漂移检测警告级别和漂移级别的算法,通过检测分类错误率是否降低来判断是否发生概念漂移,在检测突变类概念漂移时效果很好,但对渐变类概念漂移的检测效果不理想.Baena⁃Garc et al[6]在DDM的基础上提出早期漂移检测方法(EDDM),对DDM算法进行改进,使其在渐变类概念漂移中有很好的效果.在此基础上,Frias⁃Blanco et al[7]提出基于Hoeffding不等式识别漂移临界区域的HDDM_A和HDDM_W算法.Bifet and Gavaldà[19]提出自适应滑动窗口算法(Adaptive Sliding Window,ADWIN),采用滑动窗口机制,根据时间和数据分布的改变进行自适应改变,但算法性能取决于窗口的大小,如何选择窗口大小是决定算法性能的关键. ...
Adaptive random forests for evolving data stream classification
2
2017
... 近年来有关概念漂移的研究不少,但现有的概念漂移检测适应算法更侧重于单一类型的概念漂移.例如,DDM (Drift Detection Method)[5]通过分类错误率来判断是否发生概念漂移,适用于突变型概念漂移.EDDM (Early Drift Detection Method)[6]改进了DDM,通过分类错误率间的距离来判断是否发生概念漂移,适用于渐变类型概念漂移.HDDM_W和HDDM_A[7]均根据Hoeff⁃ding不等式识别概念漂移,前者适用于渐变型概念漂移,后者对突变型概念漂移效果很好.自适应随机森林(Adaptive Random Forests,ARF)[8]和流随机补丁(Streaming Random Patch,SRP)[9]算法在检测概念漂移后,模型会进行自适应调整,但在面对多种复杂的概念漂移时效果不理想.基于以上,本文改进了ARF和SRP算法,并以此为基础提出一种适应流式数据概念漂移的在线集成自适应算法(KSHPR),实验验证该算法能有效地提高学习模型预测的准确率.与其他算法相比,本文的主要贡献如下: ...
... 被动适应方法不判断数据分布是否发生变化,而是通过不断地更新分类器来适应概念漂移.被动适应方法主要有基于决策树、增量学习和基于集成的算法.霍夫丁树(Hoeffding Tree,HT)算法[20]是一种基于决策树的算法,使用霍夫丁界来计算选择分割节点所需的样本数量,可以更新其节点以适应新传入的样本,但没有机制来解决特定类型的漂移.Gomes et al[8]提出ARF算法,使用Hoeffding作为基学习者,通过重采样和随机选择节点分裂的特征子集来诱导多样性,但该算法采用局部子空间随机化策略,容易陷入局部最优.在此基础上,Gomes et al[9]提出一种新的自适应集成算法SRP用于流数据分析,使用全局子空间随机化策略以提升算法精确度.ARF和SRP算法均选择ADWIN作为概念漂移检测器,算法性能取决于窗口的大小. ...
Streaming random patches for evolving data stream classification
2
2019
... 近年来有关概念漂移的研究不少,但现有的概念漂移检测适应算法更侧重于单一类型的概念漂移.例如,DDM (Drift Detection Method)[5]通过分类错误率来判断是否发生概念漂移,适用于突变型概念漂移.EDDM (Early Drift Detection Method)[6]改进了DDM,通过分类错误率间的距离来判断是否发生概念漂移,适用于渐变类型概念漂移.HDDM_W和HDDM_A[7]均根据Hoeff⁃ding不等式识别概念漂移,前者适用于渐变型概念漂移,后者对突变型概念漂移效果很好.自适应随机森林(Adaptive Random Forests,ARF)[8]和流随机补丁(Streaming Random Patch,SRP)[9]算法在检测概念漂移后,模型会进行自适应调整,但在面对多种复杂的概念漂移时效果不理想.基于以上,本文改进了ARF和SRP算法,并以此为基础提出一种适应流式数据概念漂移的在线集成自适应算法(KSHPR),实验验证该算法能有效地提高学习模型预测的准确率.与其他算法相比,本文的主要贡献如下: ...
... 被动适应方法不判断数据分布是否发生变化,而是通过不断地更新分类器来适应概念漂移.被动适应方法主要有基于决策树、增量学习和基于集成的算法.霍夫丁树(Hoeffding Tree,HT)算法[20]是一种基于决策树的算法,使用霍夫丁界来计算选择分割节点所需的样本数量,可以更新其节点以适应新传入的样本,但没有机制来解决特定类型的漂移.Gomes et al[8]提出ARF算法,使用Hoeffding作为基学习者,通过重采样和随机选择节点分裂的特征子集来诱导多样性,但该算法采用局部子空间随机化策略,容易陷入局部最优.在此基础上,Gomes et al[9]提出一种新的自适应集成算法SRP用于流数据分析,使用全局子空间随机化策略以提升算法精确度.ARF和SRP算法均选择ADWIN作为概念漂移检测器,算法性能取决于窗口的大小. ...
数据流概念漂移处理方法研究综述
1
2022
... 概念漂移是数据分布随时间发生变化的一种现象.不同的文献将概念漂移分为不同的类别,陈志强等[10]将概念漂移分为突变型、渐变型、增量型和重复型四类.De Barros and Santos[11]将概念漂移分为突变型、渐变型和重复型三类,但根据其发生变化的时间来看,主要是数据分布的突然变化和持续一段时间后再变化两种情况.因此,本文将概念漂移分为突变类概念漂移[12]和渐变类概念漂移[13]两大类进行研究. ...
Survey of concept drift handling methods in data streams
1
2022
... 概念漂移是数据分布随时间发生变化的一种现象.不同的文献将概念漂移分为不同的类别,陈志强等[10]将概念漂移分为突变型、渐变型、增量型和重复型四类.De Barros and Santos[11]将概念漂移分为突变型、渐变型和重复型三类,但根据其发生变化的时间来看,主要是数据分布的突然变化和持续一段时间后再变化两种情况.因此,本文将概念漂移分为突变类概念漂移[12]和渐变类概念漂移[13]两大类进行研究. ...
An overview and comprehensive comparison of ensembles for concept drift
1
2019
... 概念漂移是数据分布随时间发生变化的一种现象.不同的文献将概念漂移分为不同的类别,陈志强等[10]将概念漂移分为突变型、渐变型、增量型和重复型四类.De Barros and Santos[11]将概念漂移分为突变型、渐变型和重复型三类,但根据其发生变化的时间来看,主要是数据分布的突然变化和持续一段时间后再变化两种情况.因此,本文将概念漂移分为突变类概念漂移[12]和渐变类概念漂移[13]两大类进行研究. ...
An ensemble learning approach for concept drift
1
2014
... 概念漂移是数据分布随时间发生变化的一种现象.不同的文献将概念漂移分为不同的类别,陈志强等[10]将概念漂移分为突变型、渐变型、增量型和重复型四类.De Barros and Santos[11]将概念漂移分为突变型、渐变型和重复型三类,但根据其发生变化的时间来看,主要是数据分布的突然变化和持续一段时间后再变化两种情况.因此,本文将概念漂移分为突变类概念漂移[12]和渐变类概念漂移[13]两大类进行研究. ...
Concept drift detection in streams of labelled data using the restricted Boltzmann machine
1
2018
... 概念漂移是数据分布随时间发生变化的一种现象.不同的文献将概念漂移分为不同的类别,陈志强等[10]将概念漂移分为突变型、渐变型、增量型和重复型四类.De Barros and Santos[11]将概念漂移分为突变型、渐变型和重复型三类,但根据其发生变化的时间来看,主要是数据分布的突然变化和持续一段时间后再变化两种情况.因此,本文将概念漂移分为突变类概念漂移[12]和渐变类概念漂移[13]两大类进行研究. ...
A novel concept drift detection method for incremental learning in nonstationary environments
1
2020
... 有关概念漂移的研究主要分两个重点研究方向:一是主动检测数据是否发生概念漂移,二是在检测到概念漂移以后模型如何做自适应的调整.基于此,可将有关概念漂移的算法分为主动方法[14-16]和被动适应[17-18].主动方法通过检测数据分布是否发生变化、分类器的性能是否降低来判断概念漂移,主要针对急促的分布改变,重点在迅速检测到概念漂移的发生以及发生的具体时间点,主要分为基于模型性能、基于窗口机制和假设检验算法.DDM是第一个定义概念漂移检测警告级别和漂移级别的算法,通过检测分类错误率是否降低来判断是否发生概念漂移,在检测突变类概念漂移时效果很好,但对渐变类概念漂移的检测效果不理想.Baena⁃Garc et al[6]在DDM的基础上提出早期漂移检测方法(EDDM),对DDM算法进行改进,使其在渐变类概念漂移中有很好的效果.在此基础上,Frias⁃Blanco et al[7]提出基于Hoeffding不等式识别漂移临界区域的HDDM_A和HDDM_W算法.Bifet and Gavaldà[19]提出自适应滑动窗口算法(Adaptive Sliding Window,ADWIN),采用滑动窗口机制,根据时间和数据分布的改变进行自适应改变,但算法性能取决于窗口的大小,如何选择窗口大小是决定算法性能的关键. ...
基于散度的网络流概念漂移分类方法
0
2020
A classification approach based on divergence for network traffic in presence of concept drift
0
2020
基于信息熵的自适应网络流概念漂移分类方法
1
2017
... 有关概念漂移的研究主要分两个重点研究方向:一是主动检测数据是否发生概念漂移,二是在检测到概念漂移以后模型如何做自适应的调整.基于此,可将有关概念漂移的算法分为主动方法[14-16]和被动适应[17-18].主动方法通过检测数据分布是否发生变化、分类器的性能是否降低来判断概念漂移,主要针对急促的分布改变,重点在迅速检测到概念漂移的发生以及发生的具体时间点,主要分为基于模型性能、基于窗口机制和假设检验算法.DDM是第一个定义概念漂移检测警告级别和漂移级别的算法,通过检测分类错误率是否降低来判断是否发生概念漂移,在检测突变类概念漂移时效果很好,但对渐变类概念漂移的检测效果不理想.Baena⁃Garc et al[6]在DDM的基础上提出早期漂移检测方法(EDDM),对DDM算法进行改进,使其在渐变类概念漂移中有很好的效果.在此基础上,Frias⁃Blanco et al[7]提出基于Hoeffding不等式识别漂移临界区域的HDDM_A和HDDM_W算法.Bifet and Gavaldà[19]提出自适应滑动窗口算法(Adaptive Sliding Window,ADWIN),采用滑动窗口机制,根据时间和数据分布的改变进行自适应改变,但算法性能取决于窗口的大小,如何选择窗口大小是决定算法性能的关键. ...
An adaptive classification approach based on information entropy for network traffic in presence of concept drift
1
2017
... 有关概念漂移的研究主要分两个重点研究方向:一是主动检测数据是否发生概念漂移,二是在检测到概念漂移以后模型如何做自适应的调整.基于此,可将有关概念漂移的算法分为主动方法[14-16]和被动适应[17-18].主动方法通过检测数据分布是否发生变化、分类器的性能是否降低来判断概念漂移,主要针对急促的分布改变,重点在迅速检测到概念漂移的发生以及发生的具体时间点,主要分为基于模型性能、基于窗口机制和假设检验算法.DDM是第一个定义概念漂移检测警告级别和漂移级别的算法,通过检测分类错误率是否降低来判断是否发生概念漂移,在检测突变类概念漂移时效果很好,但对渐变类概念漂移的检测效果不理想.Baena⁃Garc et al[6]在DDM的基础上提出早期漂移检测方法(EDDM),对DDM算法进行改进,使其在渐变类概念漂移中有很好的效果.在此基础上,Frias⁃Blanco et al[7]提出基于Hoeffding不等式识别漂移临界区域的HDDM_A和HDDM_W算法.Bifet and Gavaldà[19]提出自适应滑动窗口算法(Adaptive Sliding Window,ADWIN),采用滑动窗口机制,根据时间和数据分布的改变进行自适应改变,但算法性能取决于窗口的大小,如何选择窗口大小是决定算法性能的关键. ...
Adaptive online extreme learning machine by regulating forgetting factor by concept drift map
1
2019
... 有关概念漂移的研究主要分两个重点研究方向:一是主动检测数据是否发生概念漂移,二是在检测到概念漂移以后模型如何做自适应的调整.基于此,可将有关概念漂移的算法分为主动方法[14-16]和被动适应[17-18].主动方法通过检测数据分布是否发生变化、分类器的性能是否降低来判断概念漂移,主要针对急促的分布改变,重点在迅速检测到概念漂移的发生以及发生的具体时间点,主要分为基于模型性能、基于窗口机制和假设检验算法.DDM是第一个定义概念漂移检测警告级别和漂移级别的算法,通过检测分类错误率是否降低来判断是否发生概念漂移,在检测突变类概念漂移时效果很好,但对渐变类概念漂移的检测效果不理想.Baena⁃Garc et al[6]在DDM的基础上提出早期漂移检测方法(EDDM),对DDM算法进行改进,使其在渐变类概念漂移中有很好的效果.在此基础上,Frias⁃Blanco et al[7]提出基于Hoeffding不等式识别漂移临界区域的HDDM_A和HDDM_W算法.Bifet and Gavaldà[19]提出自适应滑动窗口算法(Adaptive Sliding Window,ADWIN),采用滑动窗口机制,根据时间和数据分布的改变进行自适应改变,但算法性能取决于窗口的大小,如何选择窗口大小是决定算法性能的关键. ...
Kappa updated ensemble for drifting data stream mining
1
2020
... 有关概念漂移的研究主要分两个重点研究方向:一是主动检测数据是否发生概念漂移,二是在检测到概念漂移以后模型如何做自适应的调整.基于此,可将有关概念漂移的算法分为主动方法[14-16]和被动适应[17-18].主动方法通过检测数据分布是否发生变化、分类器的性能是否降低来判断概念漂移,主要针对急促的分布改变,重点在迅速检测到概念漂移的发生以及发生的具体时间点,主要分为基于模型性能、基于窗口机制和假设检验算法.DDM是第一个定义概念漂移检测警告级别和漂移级别的算法,通过检测分类错误率是否降低来判断是否发生概念漂移,在检测突变类概念漂移时效果很好,但对渐变类概念漂移的检测效果不理想.Baena⁃Garc et al[6]在DDM的基础上提出早期漂移检测方法(EDDM),对DDM算法进行改进,使其在渐变类概念漂移中有很好的效果.在此基础上,Frias⁃Blanco et al[7]提出基于Hoeffding不等式识别漂移临界区域的HDDM_A和HDDM_W算法.Bifet and Gavaldà[19]提出自适应滑动窗口算法(Adaptive Sliding Window,ADWIN),采用滑动窗口机制,根据时间和数据分布的改变进行自适应改变,但算法性能取决于窗口的大小,如何选择窗口大小是决定算法性能的关键. ...
Learning from time?changing data with adaptive windowing
1
2007
... 有关概念漂移的研究主要分两个重点研究方向:一是主动检测数据是否发生概念漂移,二是在检测到概念漂移以后模型如何做自适应的调整.基于此,可将有关概念漂移的算法分为主动方法[14-16]和被动适应[17-18].主动方法通过检测数据分布是否发生变化、分类器的性能是否降低来判断概念漂移,主要针对急促的分布改变,重点在迅速检测到概念漂移的发生以及发生的具体时间点,主要分为基于模型性能、基于窗口机制和假设检验算法.DDM是第一个定义概念漂移检测警告级别和漂移级别的算法,通过检测分类错误率是否降低来判断是否发生概念漂移,在检测突变类概念漂移时效果很好,但对渐变类概念漂移的检测效果不理想.Baena⁃Garc et al[6]在DDM的基础上提出早期漂移检测方法(EDDM),对DDM算法进行改进,使其在渐变类概念漂移中有很好的效果.在此基础上,Frias⁃Blanco et al[7]提出基于Hoeffding不等式识别漂移临界区域的HDDM_A和HDDM_W算法.Bifet and Gavaldà[19]提出自适应滑动窗口算法(Adaptive Sliding Window,ADWIN),采用滑动窗口机制,根据时间和数据分布的改变进行自适应改变,但算法性能取决于窗口的大小,如何选择窗口大小是决定算法性能的关键. ...
Data stream mining:Methods and challenges for handling concept drift
1
2019
... 被动适应方法不判断数据分布是否发生变化,而是通过不断地更新分类器来适应概念漂移.被动适应方法主要有基于决策树、增量学习和基于集成的算法.霍夫丁树(Hoeffding Tree,HT)算法[20]是一种基于决策树的算法,使用霍夫丁界来计算选择分割节点所需的样本数量,可以更新其节点以适应新传入的样本,但没有机制来解决特定类型的漂移.Gomes et al[8]提出ARF算法,使用Hoeffding作为基学习者,通过重采样和随机选择节点分裂的特征子集来诱导多样性,但该算法采用局部子空间随机化策略,容易陷入局部最优.在此基础上,Gomes et al[9]提出一种新的自适应集成算法SRP用于流数据分析,使用全局子空间随机化策略以提升算法精确度.ARF和SRP算法均选择ADWIN作为概念漂移检测器,算法性能取决于窗口的大小. ...
DDD:A new ensemble approach for dealing with concept drift