南京大学学报(自然科学), 2021, 57(5): 818-827 doi: 10.13232/j.cnki.jnju.2021.05.012

基于特定用户约束的概率矩阵分解算法

郝昱猛, 马文明,, 王冰

烟台大学计算机与控制工程学院,烟台,264005

Probabilistic matrix factorization algorithm based on specific user constraints

Hao Yumeng, Ma Wenming,, Wang Bing

School of Computer and Control Engineering,Yantai University,Yantai,264005,China

通讯作者: E⁃mail:mwmytu@126.com

收稿日期: 2021-06-02   网络出版日期: 2021-09-29

基金资助: 国家自然科学基金.  61602399
烟台大学研究生科技创新基金.  YDZD2119

Received: 2021-06-02   Online: 2021-09-29

摘要

近年来,推荐系统的实用价值越来越高,良好的推荐算法可以给用户提供好的用户体验效果,然而随着信息化的不断增长,信息过载问题变得越来越突出,用户懒于对物品评分已经成为习惯.怎样向这些特定用户群体提供好的推荐算法、提高推荐质量已经成为现在的热门问题.为了更好地推动推荐系统的发展,解决这些特定用户群体的评分稀疏问题,提出一种受约束的贝叶斯概率矩阵分解算法.该算法针对特定的评分稀疏用户引入一种潜在的相似度约束矩阵来影响用户的特征向量,并结合最大后验概率(Maximum A Posteriori,MAP)估计和蒙特卡罗采样(Markov Chain Monte Carlo,MCMC)推断进行概率矩阵分解(Probabilistic Matrix Factorization,PMF),自动调整模型正则化参数,最后在数据集上进行测试评估和对比实验.实验结果表明,该算法在预测性能上得到很大提升,并且在解决特定用户的评分稀疏问题上效果更佳.

关键词: 推荐系统 ; 评分稀疏 ; 约束矩阵 ; 概率矩阵分解 ; 协同过滤

Abstract

In recent years,the practical value of recommender system is getting higher and higher. A good recommendation algorithm can provide a good experience effect for users. However,with the continuous growth of information technology,the problem of information overload has become more and more prominent. The formation of living habits for users is to be lazy about rating items. How to provide good recommendation algorithm to these specific user groups and to improve the recommendation quality has become a hot issue now. In order to improve recommender system and solve rating sparse problem of specific user groups,a constrained Bayesian probability matrix factorization algorithm is proposed. This algorithm introduces a potential similarity constraint matrix to affect user eigenvectors for specific sparse rating users. We combine Maximum A Posteriori (MAP) and Markov Chain Monte Carlo (MCMC) for Probabilistic Matrix Factorization (PMF),automatically adjusting the regularization parameters. Finally,test evaluation and comparison experiments are conducted on the MovieLens dataset. The experimental results show that the proposed algorithm can improve prediction performance and perform well for specific users with sparse ratings.

Keywords: recommendation system ; data sparseness ; constraint matrix ; probabilistic matrix factorization ; collaborative filtering

PDF (737KB) 元数据 多维度评价 相关文章 导出 EndNote| Ris| Bibtex  收藏本文

本文引用格式

郝昱猛, 马文明, 王冰. 基于特定用户约束的概率矩阵分解算法. 南京大学学报(自然科学)[J], 2021, 57(5): 818-827 doi:10.13232/j.cnki.jnju.2021.05.012

Hao Yumeng, Ma Wenming, Wang Bing. Probabilistic matrix factorization algorithm based on specific user constraints. Journal of nanjing University[J], 2021, 57(5): 818-827 doi:10.13232/j.cnki.jnju.2021.05.012

推荐系统(Recommendation System,RS)[1-3]提前给用户列出他们感兴趣的物品或项目,所以能为用户节省很多挑选商品的时间.RS最早的应用领域局限于电影、音乐和电视节目的推荐,随着使用范围的扩大,RS逐渐应用于购物推荐[4]、书籍推荐[5]和事件推荐[6-7]等.现在国内外应用RS最广泛的平台有天猫、京东、亚马逊、豆瓣、MEETUP等,RS为他们的用户提供高效快捷的推荐列表,能提高用户的满意度,而平台也获得了更好的经济效益.大多数RS中,最经常使用的是协同过滤算法(Colla⁃borative Filtering,CF)[8-9],它通过分析用户的偏好信息,预测其可能喜爱的物品.

如今用户评分矩阵十分稀疏,所以传统推荐算法很难为用户配置准确的推荐列表.在这种情况下,CF利用用户与项目之间的交互并根据用户与数据集中其他可用用户的相似信息来生成项目预测,产生推荐列表.矩阵分解(Matrix Factorization,MF)[10-11]技术在CF中被成功地使用,它通过考虑用户与项目之间的互动因素(潜在特征),有效地解决了评分矩阵数据量大、数据稀疏等问题.

随着用户对推荐准确性的要求越来越高,有很多方法通过改进MF技术来保障预测精度.Ortega et al[12]提出一种基于伯努利分布的矩阵分解算法,利用模型分布的二进制性质提高推荐的准确性和可靠性,但该算法在稀疏矩阵问题上仍需改进.陈珏伊等[13]提出一种基于迁移学习的联合矩阵分解算法,通过捕捉用户的潜在特征提高相似性度量效果,该算法在解决书籍稀疏问题上有很好的效果,但算法复杂度较高,计算时间较长.Salakhutdinov and Mnih[14]通过对概率矩阵分解(Probabilistic Matrix Factorization,PMF)引入约束矩阵,可以有效解决数据稀疏问题,提高预测准确性,但其模型参数需要手动调节,很容易产生过拟合问题.Salakhutdinov and Mnih[15]还通过引入贝叶斯模型并使用蒙特卡罗采样(Markov Chain Monte Carlo,MCMC)对模型参数进行自动控制,能有效地解决模型的过拟合和优化问题,但针对特有的评分非常稀疏的用户,模型没有给出很好的预测.

本研究针对推荐系统中存在的数据稀疏、预测准确性等问题,提出一种带有用户约束的基于贝叶斯的概率矩阵分解优化算法,通过对用户引入特征向量以外的约束向量来提高用户之间的相似性,并使用最大后验概率估计[16]自动确定MCMC采样器的起点来逼近模型参数的后验分布,有效地提高了推荐算法的可解释性.

本文的主要贡献:

(1)介绍有约束的概率矩阵分解模型和基于贝叶斯的概率矩阵模型,并总结了两个模型的特点.

(2)提出新的有约束矩阵的贝叶斯概率矩阵分解模型,通过增加约束矩阵对模型进行优化,采用MCMC采样方法对超参数进行采样.

(3)实验结果证明,本文提出的优化算法与其他算法比较,模型的预测效果更好.

1 相关理论

本节主要介绍有约束的概率矩阵分解(Constrained Probabilistic Matrix Factorization,CPMF)模型和基于贝叶斯的概率矩阵分解(Bayesian Probabilistic Matrix Factorization,BPMF)模型的基本方法,介绍了两种模型对传统的矩阵分解模型进行改进的相关研究.

1.1 CPMF模型

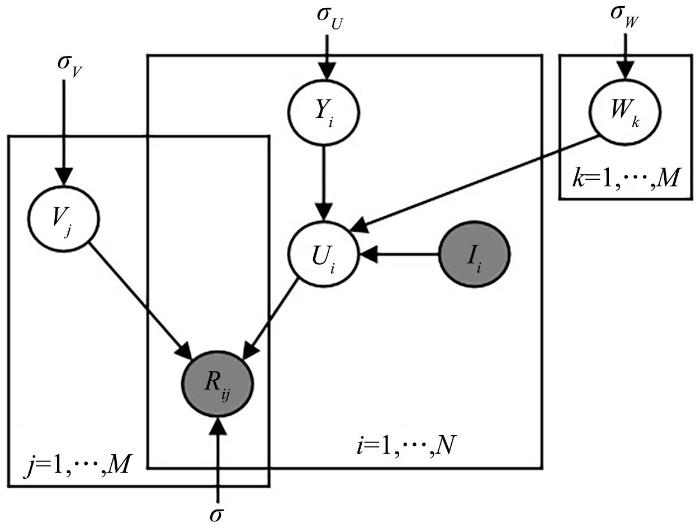
2007年Salakhutdinov and Mnih[14]提出PMF模型.假设评分矩阵为R=RijN×M,其中i∈N(N表示有N个用户),j∈M(M表示有M个电影),Rij表示用户i对电影j的评分矩阵.用户和电影的特征向量分别为U∈RN×D,V∈RM×D,D为D维的潜在特征向量.CPMF模型是在PMF模型的基础上引入约束矩阵W∈RM×D来约束特定于用户的特征向量,这对于评分不频繁的用户有很强的影响.CPMF模型的概率图模型如图1所示,模型定义的新的用户特征向量如式(1)所示:

图1

图1   CPMF模型

Fig.1   CPMF model


Ui=Yi+∑k=1MIikWk∑k=1MIik

Iik为观察到的指示矩阵Iij,如果用户i对电影j进行了评分,那么Iij=1,否则Iij=0.这里可以看出W矩阵的第i列表示的是捕捉用户对特定电影的评分对用户特征向量的先验平均值的影响,所以看过共同电影的用户对其特征向量有相似的先验分布.这里的Yi是为了获取用户i的特征向量Ui而添加到先验分布平均值的偏移值.式(2)为重新定义的模型条件分布函数:

PRU,V,W,σ2=∏i=1N∏j=1M𝒩RijgUiTVj,σ2Iij

使用Logistic函数[17]gx=11+e-x来传递用户U与电影V之间的点积,其中用户特征向量U、电影特征向量V和约束特征向量W的元素都是服从均值为0,方差分别为σU2,σV2和σW2的高斯先验分布,它们的定义函数分别为:

PUσU2=∏i=1N𝒩Ui0,σU2I
PVσV2=∏j=1M𝒩Vj0,σV2I
PWσW2=∏k=1M𝒩Wk0,σW2I

为计算方便,对U,V和W的后验分布取自然对数,得到的对数后验函数的最大值等价于最小化含有二次正则项的平方误差和的目标函数,这里使用梯度下降法进行目标函数的最小化.对比传统的PMF模型可用发现,引入约束矩阵和Logistic函数对评分稀疏的特定用户有很好的推荐效果,但没有很好地解决过拟合问题.

1.2 基于贝叶斯的概率矩阵分解(BPMF)模型

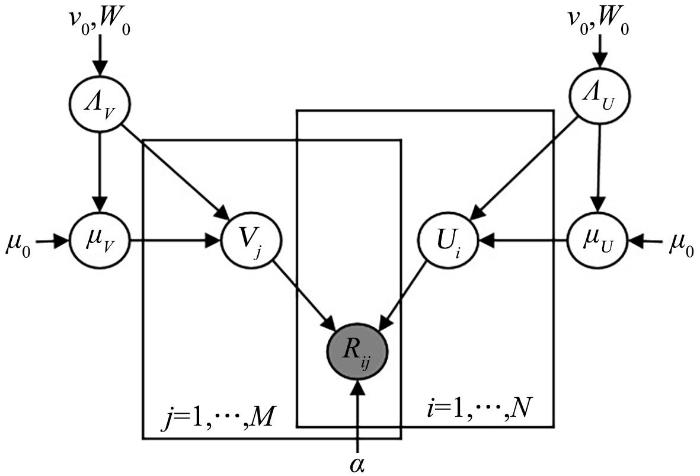
Salakhutdinov and Mnih[15]又提出将矩阵分解模型应用于贝叶斯框架中,生成具有多元高斯先验分布的评分概率模型,即BPMF模型,如图2所示.模型中用户U和电影V的概率分布单独存在:

图2

图2   基于贝叶斯的PMF模型

Fig.2   Bayesian PMF model


PUμU,ΛU=∏i=1N𝒩UiμU,ΛU-1
PVμV,ΛV=∏j=1M𝒩VjμV,ΛV-1

用户对电影的评分目标函数可以表示为:

PRU,V,α=∏i=1N∏j=1M𝒩RijUiTVj,α-1Iij

𝒩Rijμ,α-1表示期望值为μ、方差为α-1的高斯分布.为了提高模型的预测性,将先验分布设置为高斯⁃威沙特分布,其中ΘU=μU,ΛU,ΘV=μV,ΛV.μU,μV通常设置为0,这里为了寻找更合适的参数,将ΛU,ΛV封装在模型内部,可以减少优化参数过程.

PΘUΘ0=PμUΛUPΛU=𝒩μUμ0,β0ΛU-1𝒲ΛUW0,v0
PΘVΘ0=PμVΛVPΛV=𝒩μVμ0,β0ΛV-1𝒲ΛVW0,v0

𝒲是自由度为v0、协方差矩阵为W0的威沙特分布,同时设置Θ0=μ0,v0,W0,v0=D,μ0=0.

BPMF模型使用MCMC方法中的吉布斯采样器,从先验分布和超先验分布中采样来进行近似推理.实验证明,该算法可以自动调整参数,提高模型的预测精度,但由于没有很好地确定采样的起点,所以采样时间比较缓慢,使BPMF模型不能高效地发挥性能.

2 模型构建

本节主要介绍重新创建的BPMF模型并引入新的约束特征向量,采用贝叶斯诊断和MCMC方法产生新的有约束的BPMF模型,针对一些特定用户的极其稀疏的评分矩阵进行预测,实验结果证明了模型的可行性.

2.1 有约束的BPMF (CBPMF)模型

现有的矩阵分解模型在处理评分很少的特定用户时,其用户特征与先验分布平均值相似的用户有接近的特征向量,导致推荐系统面向特定用户的推荐质量严重下降.为了更好地处理这个问题,创建新的CBPMF模型,使针对特定用户的预测评价接近电影的平均评价.引入一种约束特定用户的特征向量的额外方式,便于模型更准确地捕获用户的兴趣特征,提高预测准确率.同时,模型中使用Logistic函数传递特定用户U与电影V的点积,控制潜在因子间的非线性关系[18],并将贝叶斯框架应用到模型中,自动调整模型正则化参数.这对于数据过度拟合有很好的优化效果,该模型的创建增加了用户的预测精度和可解释性[19].

首先介绍模型参数的符号,如表1所示.

表1   模型参数的符号

Table 1  Notations of model parameters

变量描述
Rij用户i对电影j的评分
ΘU,ΘV,ΘW用户、电影、约束矩阵的高斯⁃威沙特分布的超参数
T采样次数
D潜在特征向量维度
N高斯分布函数
W威沙特分布函数
N,M分别是用户和电影的个数
Iij指示变量
W0,W1单位矩阵
μU,μV,μW用户、电影、约束矩阵的高斯分布的均值参数
ΛU,ΛV,ΛW用户、电影、约束矩阵的高斯分布的方差矩阵
gxLogistic函数

新窗口打开| 下载CSV


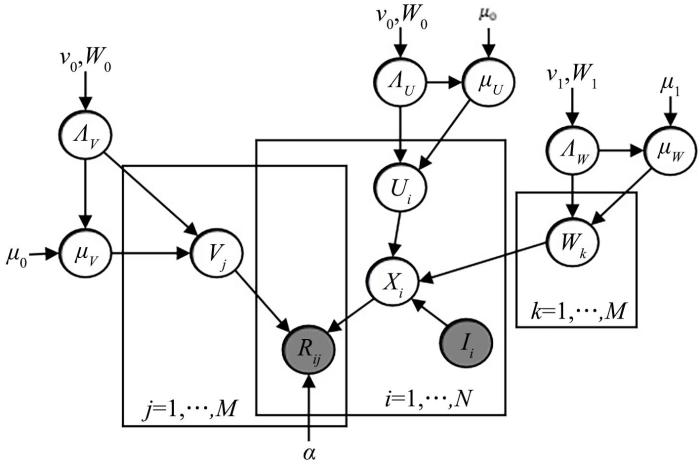
CBPMF的模型如图3所示,其核心优化方法是在用户特征向量中引入潜在的相似度约束矩阵来约束用户特征,避免用户特征接近先验分布的平均值.这里设置潜在的相似度约束矩阵W∈RM×D,用户新的特征向量为:

Xi=Ui+∑k=1MIikWk∑k=1MIik

图3

图3   CBPMF模型

Fig.3   CBPMF model


式(11)表示的用户新的特征向量与式(1)相似,通过对用户Ui进行约束产生新的用户特征向量.若用户i对物品k进行评分则Iik=1,否则为0;然后累加用户i对所有物品的评分Wk,取平均值与用户i的先验分布平均值的偏移值相加得到新的用户特征向量.

根据式(2)的思想,使用Logistic函数传递用户X与电影V的点积,从而构造新的CBPMF模型的目标函数为:

PRU,V,W,α=∏i=1N∏j=1M𝒩RijgXiTVj,α-1Iij

参照式(6)和式(7),为用户和物品的概率分布函数得到约束矩阵向量的概率分布,这里假设W服从均值为μW、方差为ΛW-1的高斯分布:

PWμW,ΛW=∏k=1M𝒩WkμW,ΛW-1

同时,设定超参数ΘW=μW,ΛW的先验分布为高斯⁃威沙特分布,可以方便模型训练中后验概率的计算过程.

PΘWΘ0=PμWΛWPΛW=𝒩μWμ1,β0ΛW-1𝒲ΛWW1,v1

根据式(9)和式(10)的模型参数的初始化进一步初始化模型参数Θ0=μ0,v0,W0,μ1,v1,W1,同时,为了减少优化参数的过程将ΛU,ΛV,ΛW封装在模型内部并设定μ0=μ1=0,v0=v1=D,W0和W1为单位矩阵.

模型中用户对电影的预测评分矩阵Rij*的概率目标函数为:

PRij*R,Θ0=∬PRij*Ui,Vj,WkPU,V,WR,ΘU,ΘV,ΘWPΘU,ΘV,ΘWΘ0dU,V,WdΘU,ΘV,ΘW

由于后验分布的求解比较复杂,难以解决评分矩阵的预测精度,这里使用MCMC采样方法对复杂的目标函数进行近似推理:

PRij*R,Θ0≈1T∑t=1TPRij*Uit,Vjt,Wkt

这里T表示采样的次数,模型通过马尔可夫链采样获得Uit,Vjt,Wkt并产生适合模型的参数和超参数U,V,W,ΘU,ΘV,ΘW的后验分布.

2.2 CBPMF模型推断

在CBPMF模型中,为了易于对模型参数和超参数进行采样,使用贝叶斯推断的方法.由于模型的参数和超参数使用共轭先验的方法从后验分布导出的条件分布进行采样,采样样本数据会直接影响推断精度,所以使用MCMC方法中的吉布斯采样(Gibbs Sampling)进行贝叶斯诊断.由于该模型在Pymc3框架上进行搭建,可以方便地使用鲍威尔优化(Powell Optimization)中的scipy.optimize.fmin_powell方法快速找到模型的最大后验概率(Maximum A Posteriori,MAP)估计,这样可以快速确定MCMC采样器的起点,节省采样时间.

在对CBPMF模型中的用户进行采样时,在其他条件已经确定的情况下,用户Ui的后验概率目标函数:

PUiR,V,W,ΘU,α∝∏j=1M𝒩RijgXiVj,α-1IijPUiμU,ΛU

为了进一步简化用户Ui的后验概率目标函数,对gXiTVj进行麦克劳林展开:

𝒩RijgXiTVj,α-1≈𝒩Rij12+XiTVj4,α-1=𝒩4Rij-2XiTVj,α4-1

由于后验分布转换成的条件分布更有利于模型的采样,这里采用共轭先验对参数和超参数进行处理,可以看出用户特征向量Ui的条件分布服从高斯分布:

PUiR,V,W,ΘU,α∝PRUi,V,W,αPUiΘU≈∏j=1M𝒩4Rij-2XiTVj,α4-1Iij∙𝒩UiμU,ΛU∝𝒩UiμUi*,ΛUi*-1

其中,

ΛUi*=ΛU+α4∑j=1MVjVjTIij∙𝒩UiμU,ΛU
μUi*=ΛUi*-1α4∑j=1MVj4Rij-2Iij+ΛUμU

同理,可以对PVjR,U,W,ΘV,α进行求解,这里省略了计算过程,现在只需要重新计算W的条件后验概率:

PWkR,U,V,ΘW,α∝PRWk,U,V,αPWkΘW≈∏j=1M𝒩RijgXiTVj,α-1Iij∙𝒩WkμW,ΛW∝𝒩WkμWk*,ΛWk*-1

其中,

ΛWk*=ΛW+α∑j=1MgXiTVj2Iij∙𝒩UiμU,ΛU
μWk*=ΛWk*-1∙α∑j=1MgXiTVjRijIij+ΛWμW

潜在的相似度约束矩阵W的超参数ΘW的条件分布可以由高斯⁃威沙特分布得出:

因为:

PμW,ΛWΘ0=𝒩μWμ1,β0ΛW-1𝒲ΛWW1,v1

所以:

PΛWW,Θ0=𝒲ΛWWW*,v1+NPμWΛW,W,Θ0=𝒩μWβμ1+NW¯β0+N,ΛW-1β0+N
PΘWW,Θ0=PμWΛW,W,Θ0PΛWW,Θ0=𝒩μWβμ1+NW¯β0+N,ΛW-1β0+N𝒲ΛWWW*,v1+N

其中,WW*-1=W1-1+NS¯+β0Nβ0+Nμ1-W¯2,W¯=1N∑i=1NWi,S¯=1N∑i=1NWi2.可以容易地获取超参数ΘW的后验概率,同理可以得到ΘU和ΘV的后验概率,这就是本模型所有参数的条件概率求证过程.

2.3 算法设计

通过使用Gibbs采样对超参数ΘU,ΘV,ΘW进行采样,然后遍历更新得到U,V,W向量的特征值,通过Logistic函数传递三者间的点积,补全稀疏矩阵的空缺评分.在测试集上进行误差验证,得出算法的预测精度,如下所示.

Algorithm CBPMF

Input:用户向量U,电影向量V,约束向量W,潜在向量维度D,采样次数T.

Output:预测用户对电影没有评分的空缺评分值.

1.for sampling iterations t of T do

2.采样超参数ΘV

ΘVt~PΘVVt,Θ0

3.采样超参数ΘU

ΘUt~PΘUUt,Θ0

4.采样超参数ΘW

Θwt~PΘwWt,Θ0

5. for j of M 更新V向量 do

Vjt+1~PVjR,Vt,ΘVt

6. for i of N 更新U向量 do

Uit+1~PUiR,Ut,ΘUt

7. for k of M 更新W向量 do

Wkt+1~PWkR,Wt,ΘWt

8. end

9. end

10. end

11. for 所有的测试集数据do

12. 预测评分并计算预测误差

13. end

14.end

在计算算法的复杂度时可以看出,Dd×d维的特征向量的复杂度为Οd3,可以得出CBPMF算法的复杂度为Οd3∑j=1M∑i=1NIij,与BPMF模型算法的复杂度一样.但是本算法模型对贝叶斯模型进行了优化,使模型提取潜在特征的能力得到了提升,所以模型在特征向量维度很低的时候就可以得到很好的预测,和其他模型算法相比,本算法的时间复杂度反而更低.

3 实验设计与分析

在不同的数据集上进行实验,将提出的优化CBPMF算法在预测准确性上与PMF,CPMF和BPMF推荐算法进行比较,通过标准化的评价指标来证明该CBPMF的优越性.

3.1 数据集及评价指标

为了更好地展现CBPMF模型,在MovieLens数据集上进行两次实验,分别使用MovieLens⁃100k和MovieLens⁃1M进行实验.MovieLens⁃100k是943名用户对1682个电影的100 k个评分信息,评分密度为0.063;MovieLens⁃1M是6039名用户对8662个电影的1 M个评分信息,评分密度为0.043.这里对数据进行了预处理以控制数据的稀疏性,表2给出了数据集的相关信息统计.

表2   数据集的信息统计

Table 2  Statistic information of MovieLens datasets

数据集信息MovieLens⁃100kMovieLens⁃1M
用户数U9436039
电影数V16828662
评分范围1~50.5~5.0
评分数100 k1 M
评分密度6.3%4.3%

新窗口打开| 下载CSV


为了更好地评价本模型算法的优越性,使用推荐算法中常用的评价标准RMSE和MAE来衡量预测误差.RMSE和MAE越小,算法的准确性越好.

RMSE=∑i=1N∑j=1MIijRij-Rij*2∑i=1N∑j=1MIij
MAE=∑i=1N∑j=1MIijRij-Rij*∑i=1N∑j=1MIij

3.2 模型基线

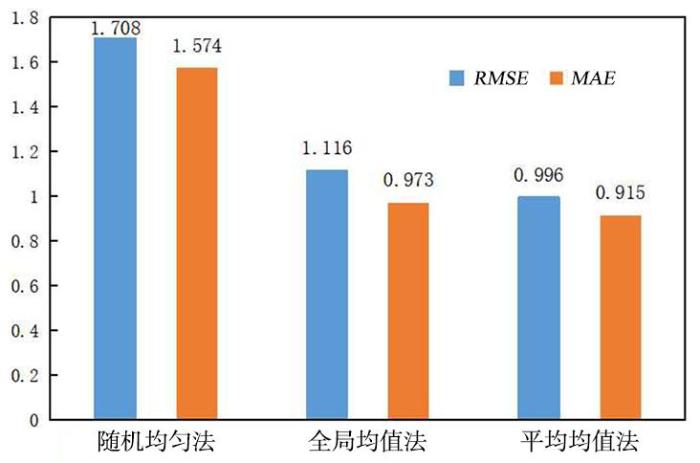
在对模型基线方法进行选择时,为了给模型预测提供一个好的参照点,本实验分别对随机均匀法、全局均值法和平均均值法进行比较,如图4所示.可以看出,随机均匀法基线效果最差,平均均值法基线效果最好,所以选取平均均值基线作为模型预测实验的最佳基线.

图4

图4   不同的模型基线方法的RMSE和MAE的比较

Fig.4   RMSE and MAE of different model baseline methods


3.3 对比实验

为了进一步证实案例的可解释性,在MovieLens数据集上进行两组实验,分别从不同的角度对本模型算法进行性能和可行性测试,最后以RMSE为评价指标进行验证.

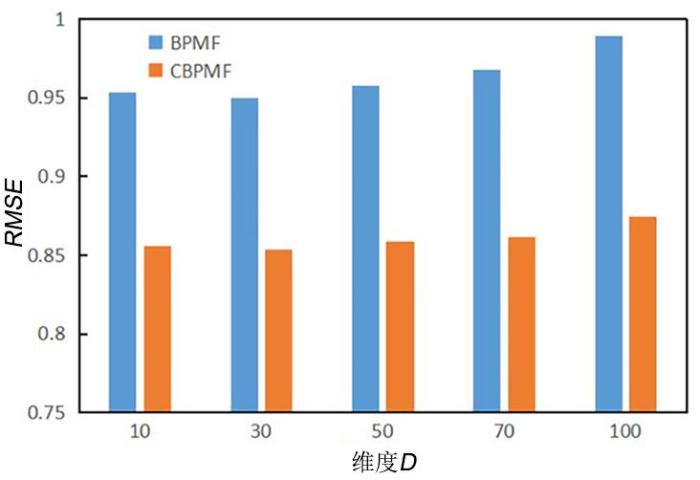
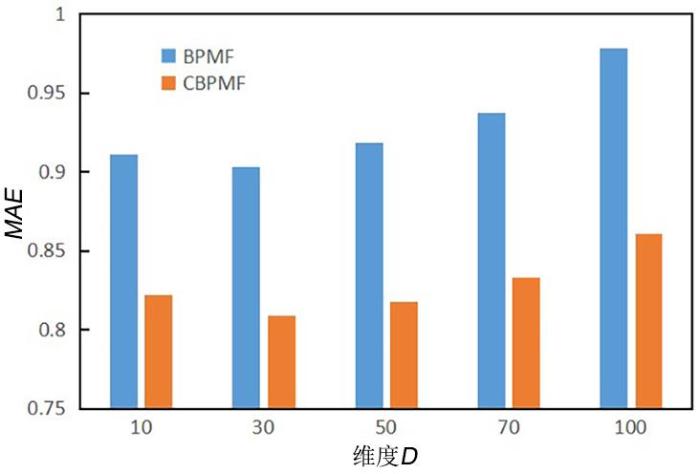
A组实验.为了进一步证明本文的优化算法在更加稀疏的数据集上性能良好,在评分密度为4.3%的MovieLens⁃1M数据集上随机选取数据集的20%为测试集、80%为训练集进行测试.通过选取不同的特征向量维度,检验算法对稀疏矩阵提取潜在特征向量的能力.设置的特征向量维度D分别为10,30,50,70,100,实验迭代epochs=100次,取算法的RMSE和MAE的平均值进行比较.实验的数据对比如表3所示,表中黑体字为数据的最优值.可以看出,在数据稀疏更加明显的情况下,CBPMF算法的RMSE和MAE比BPMF算法有明显的降低,分别减少约0.10和0.04.维度D=30时,CBPMF模型算法的RMSE和MAE最小,虽然优势不很明显,但从整体实验结果可以看出优化算法可以很好地解决数据稀疏的性能,预测精度也有很大提高.

表3   MovieLens⁃1M数据集上BPMF和CBPMF算法在不同维度下的RMSE和MAE

Table 3  The RMSE and MAE of BPMF and CBPMF in different dimensions on MovieLens⁃1M dataset

DatasetMetricsMethod10D30D50D70D100D
MovieLens⁃1MMAEBPMF0.91130.90290.91860.93740.9786
CBPMF0.82190.80870.81740.83290.8610
RMSEBPMF0.95360.94950.95790.96780.9889
CBPMF0.85610.85330.85870.86130.8743

新窗口打开| 下载CSV


图5和图6为对比数据表3的图形展示.可以看出,在传统的BPMF模型中引入约束特定用户的特征的额外向量,可以有效地解决对评分不频繁的用户预测不准确的问题.在维度很低的情况下CBPMF算法的误差值很低,预测精度更高,算法的复杂度也更低,算法的可用性更强.通过观察可知,维度D=30是模型最优的维度.

图5

图5   MovieLens⁃1M数据集上BPMF和CBPMF的RMSE比较

Fig.5   The RMSE of BPMF and CBPMF on Movie⁃Lens⁃1M dataset


图6

图6   MovieLens⁃1M数据集上BPMF和CBPMF的MAE比较

Fig.6   The MAE of BPMF and CBPMF on MovieLens⁃1M dataset


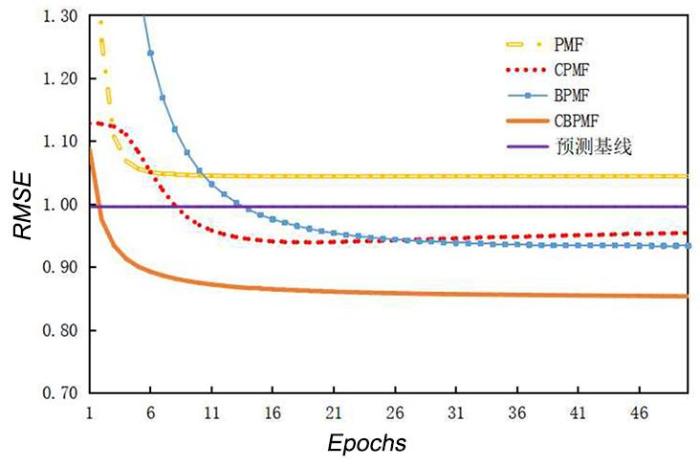
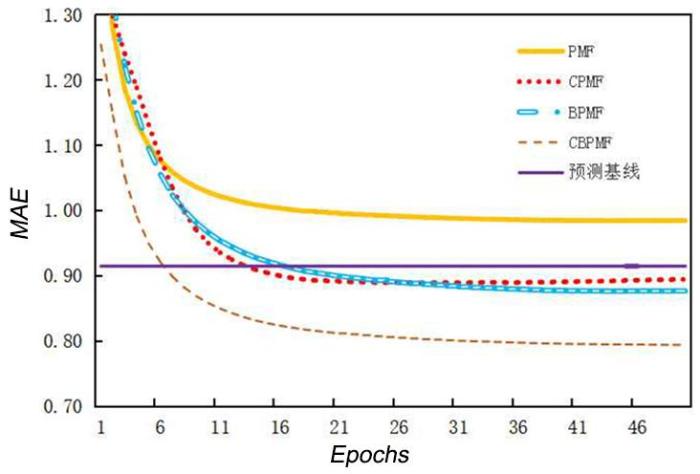
B组实验.在评分密度为6.3%的Movie⁃Lens⁃100k数据集上随机选取数据集的20%为测试集、80%为训练集进行实验.将CBPMF算法与PMF,CPMF和BPMF算法依据RMSE进行预测效果对比.实验中设置参数为α=2,β0=2,μ0=μ1=0,v0=v1=D=30,W0和W1为维度为D的单位矩阵,采样次数T=100,迭代次数epochs=50.实验结果如图7和图8所示.在MovieLens⁃100k数据集上,CBPMF的最小RMSE为0.853,而PMF,BPMF和CPMF算法的最小RMSE分别为1.044,0.933和0.939,分别提升19.1%,8%和8.6%.随着迭代次数的不断增加,CBPMF的RMSE和MAE都比其他算法更低,并且能很快地达到平稳状态.CBPMF的误差值比三种对比算法更小,模型的收敛速度也有很大的提升.综上,CBPMF的预测精度有很大提升.

图7

图7   几种算法在MovieLens⁃100k数据集上的RMSE比较

Fig.7   RMSE of different algorithms on MovieLens⁃100k dataste


图8

图8   几种算法在MovieLens⁃100k数据集上的MAE比较

Fig.8   MAE of different algorithms on MovieLens⁃100k dataset


从以上两组实验结果可看出,不论是与传统的PMF,CPMF和BPMF矩阵分解算法对比,还是在模型本身性能上进行验证,在维度大小不同以及数据集评分密度更小的情况下,本文提出的CBPMF模型算法的预测准确性都更高.所以,CBPMF算法对特定用户可以给出更好的用户体验,而商家针对评分稀疏的特定用户,也可以更快捷地推荐用户感兴趣的物品,提高推荐质量.在模型的可解释性上,和传统模型相比,CBPMF算法的超参数是采用贝叶斯中的MCMC方法对模型不断更新迭代进行采样获取的最优的模型参数,所以模型的可解释性更强,超参数的选取更合理.完整的贝叶斯定理处理算法模型可以显著地提升预言准确性.

3.4 案例分析

为了进一步验证本文优化算法的精确程度是否与用户约束矩阵有关以及是否会影响模型的预测性能,随机挑选四名用户进行实验对比,实验结果如表4所示.

表4   案例分析的比较结果

Table 4  Comparative results of case analysis

用户评分数无约束矩阵预测误差RMSE有约束矩阵预测误差RMSE
A5094.4%90.7%
B1493.6%86.6%
C598.2%82.5%
D996.4%86.2%

新窗口打开| 下载CSV


针对模型有无约束矩阵对用户进行约束,比较预测用户的评分误差RMSE来证实实验的可解释性.通过对用户的预测误差比较可以看出,对于特定用户(指用户评分相对稀疏),约束矩阵发挥了很好的预测效果,用户评分越稀疏,有约束矩阵的模型的预测误差越小,预测准确性越高.如表4所示,用户A评论了50个电影,用户C评论了5个电影,所以用户C为特定用户.有无约束矩阵对模型的评分预测影响很小,预测误差都在90%左右,然而用户C的预测对于模型有无约束矩阵影响很大.在模型计算中,对于特定评分稀疏的用户而言,由于传统模型对其预测时预测结果近似物品的平均评分,无法保证评分准确性,而对模型引入约束矩阵可以有效地缓解这一问题.用户C的预测误差RMSE提高了16%,证实了本文提出的优化算法的可解释性.

4 结 论

针对现有的协同过滤算法中的矩阵分解算法不能很好地解决那些不喜欢去评分的特定用户的评分稀疏和推荐质量不高的问题,本文提出了一种受约束的贝叶斯概率矩阵分解优化算法,通过对PMF模型引入潜在的相似度约束矩阵来影响特定用户的特征向量,这样可以更快捷地捕获用户之间的相似性以提高预测准确性,同时使用MCMC方法对模型进行采样训练,自动调整模型的正则化参数,可以更好地获得更加具有可解释性的超参数.使用Pymc3框架进行模型搭建使模型架构更加简洁,同时使用MAP估计来明确MCMC采样的起点,节约了采样时间.在稀疏评分矩阵下,CBPMF算法喝传统的推荐算法相比,预测评分的准确性得到了提升,优化算法具有很强的预测性能和可解释性.实验结果表明,在对用户特征向量之外引入潜在的相似度约束矩阵可以有效地解决特定用户评分预测不准确的问题,使推荐系统可以更准确地向特定用户推荐更感兴趣的物品.

参考文献

Resnick P,Varian H R.

Recommender systems

Communications of the ACM,1997,40(3):56-58.

[本文引用: 1]

Huang L W,Fu M S,Li F,et al.

A deep reinforcement learning based long⁃term recommender system

Knowledge⁃Based Systems,2021,213:106706.

王立才,孟祥武,张玉洁.

上下文感知推荐系统

软件学报,2012,23(1):1-20. (Wang L C,Meng X W,Zhang Y J. Context⁃aware recommender

[本文引用: 1]

systems

Journal of Software,2012,23(1):1-20.

[本文引用: 1]

倪维健,郭浩宇,刘彤等.

基于多头自注意力神经网络的购物篮推荐方法

数据分析与知识发现,2020,4(2-3):68-77. (Ni W J,Guo H Y Liu T,et al.

[本文引用: 1]

Online product recommendation based on multi⁃head self⁃attention neural networks

Data Analysis and Know⁃ledge Discovery,2020,4(2-3):68-77.

[本文引用: 1]

Hikmatyar M,Ruuhwan. Book recommendation system development using user⁃based collaborative filtering. Journal of Physics:Conference Series,2020,1477(3):032024.

[本文引用: 1]

Liu X J,He Q,Tian Y Y,et al.

Event⁃based social networks:Linking the online and offline social worlds

∥Proceedings of the 18th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining. New York,NY,USA:ACM,2012:1032-1040.

[本文引用: 1]

魏晓辉,孙冰怡,崔佳旭.

基于图神经网络的兴趣活动推荐算法

吉林大学学报(工学版),2021,51(1):278-284. (Wei X H,Sun B Y,Cui J X. Interest in activities recommended algorithm based on neural network diagram. Journal of Jilin University

[本文引用: 1]

Science) Engineering,2021,51(1:278-284.

[本文引用: 1]

夏景明,刘聪慧.

一种基于用户和商品属性挖掘的协同过滤算法

现代电子技术,2020,43(23):120-123. (Xia J M,Liu C H. A collaborative filtering

[本文引用: 1]

algorithm based on user and commodity attribute

[本文引用: 1]

mining

Modern Electronic Technology,2020,43(23):120-123.

[本文引用: 1]

孔麟,黄俊,马浩等.

融合多层相似度与信任机制的协同过滤算法

计算机工程与设计,2020,41(12):3405-3411. (Kong L,Huang J,Ma H,et al.

[本文引用: 1]

Collaborative filtering algorithm fusing multi⁃level similarity and trust mechanism.

Computer

[本文引用: 1]

Engineering and Design,2020,41(12):3405-3411.

[本文引用: 1]

王英博,孙永荻.

基于GNN的矩阵分解推荐算法

计算机工程与应用,2020:1-11.

[本文引用: 1]

Wang Y B,Sun Y D.

GNN⁃based matrix factorization recommendation algorithm

Computer Engineering and Application,2020:1-11.

[本文引用: 1]

Koren Y.

Factorization meets the neighborhood:A multifaceted collaborative filtering model

∥Proceedings of the 14th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining. New York,NY,USA:ACM,2008:426-

[本文引用: 1]

Ortega F,Lara⁃Cabrera R,González⁃Prieto Á,et al.

Providing reliability in recommender systems through Bernoulli Matrix Factorization

Information Sciences,2021(553):110-128.

[本文引用: 1]

陈珏伊,朱颖琪,周刚等.

基于迁移的联合矩阵分解的协同过滤算法

四川大学学报(自然科学版),2020,57(6):1096-1102.

[本文引用: 1]

Chen J Y,Zhu Y Q,Zhou G,et al.

Collaborative filtering recommendation based on transfer learning and joint matrix decompo⁃sition

Journal of Sichuan University (Natural Science Edition),2020,57(6):1096-1102.

[本文引用: 1]

Salakhutdinov R,Mnih A.

Probabilistic matrix factorization

∥Proceedings of the 20th International Processing Conference on Neural Information Processing Systems. New York,NY,USA:Curran Associates Inc.,2007:1257-1264.

[本文引用: 2]

Salakhutdinov R,Mnih A.

Bayesian probabilistic matrix factorization using Markov chain Monte Carlo

∥Proceedings of the 25th International Conference on Machine Learning. New York,NY,USA:ACM,2008:880-887.

[本文引用: 2]

Yang Y,Gao X G,Chen D Q,et al.

Learning Bayesian networks using the constrained maximum a posteriori probability method
Pattern Recognition,2019(91):123-134.

[本文引用: 1]

毛宜钰,刘建勋,胡蓉等.

基于Logistic函数和用户聚类的协同过滤算法

浙江大学学报(工学版),2017,51(6):1252-1258. (Mao Y Y,Liu J X,Hu R,et al. Collaborative filtering algorithm based on

[本文引用: 1]

logistic function and user clustering.

Journal of

[本文引用: 1]

Zhejiang University (Engineering Science),2017,

[本文引用: 1]

51(6):1252-1258.

[本文引用: 1]

Ning X,Karypis G.

SLIM:sparse linear methods for top⁃N recommender systems

∥2011 IEEE 11th International Conference on Data Mining. Vancouver,Canada:IEEE,2011:497-506.

[本文引用: 1]

吴宾,娄铮铮,叶阳东.

联合正则化的矩阵分解推荐算法

软件学报,2018,29(9):2681-2696.

[本文引用: 1]

Wu B,Lou Z Z,Ye Y D.

Co⁃regularized matrix factorization recommendation algorithm

Journal of Software,2018,29(9):2681-2696.

[本文引用: 1]

/

〈 〉